认识xpath的结构?
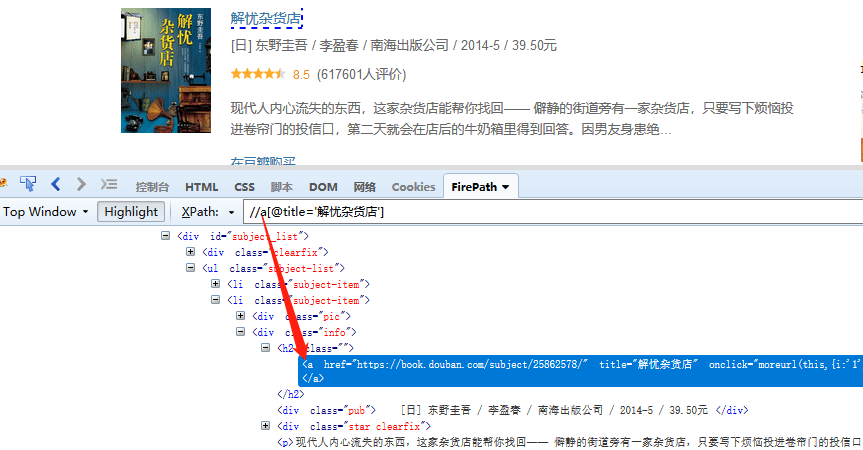
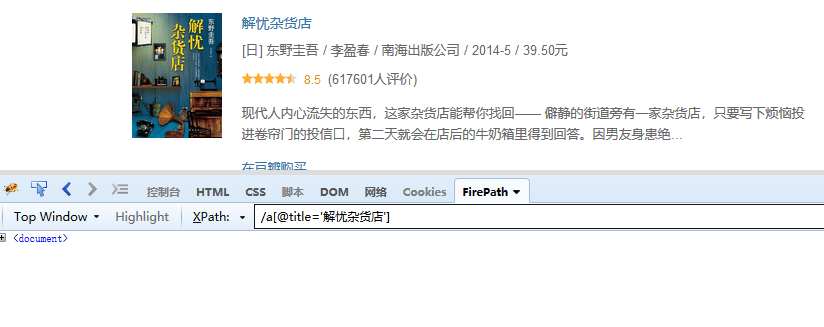
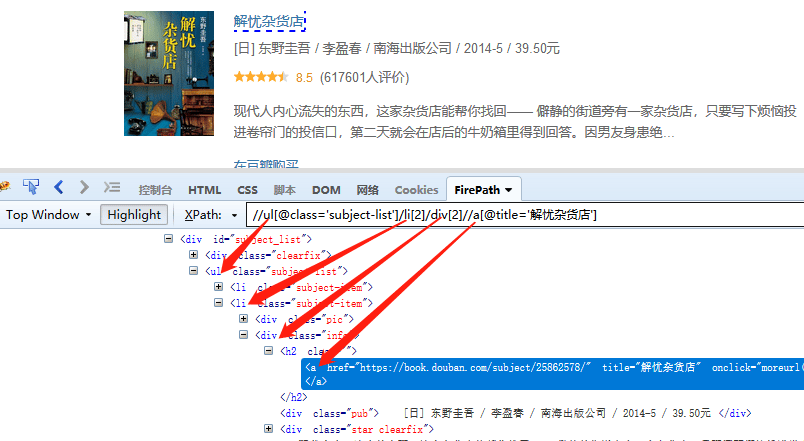
先自己自动生成几个XPath,看一下XPath结构有什么规律。几个示例XPath: .//*[@id=‘subject_list’]/ul/li[1] .//*[@id=‘subject_list’]/ul/li[1]/div[2]/p html/body//li[@class=‘next’]/a[1] 我们发现,XPath都具有相似的结构,都由3部分组成。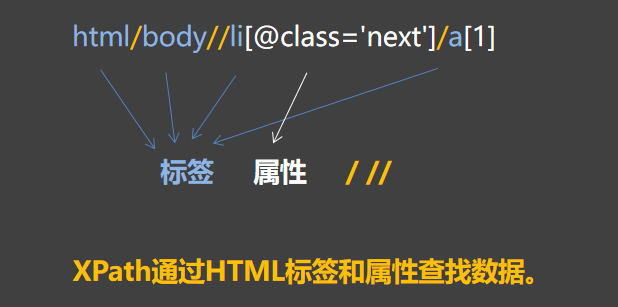
1、标签
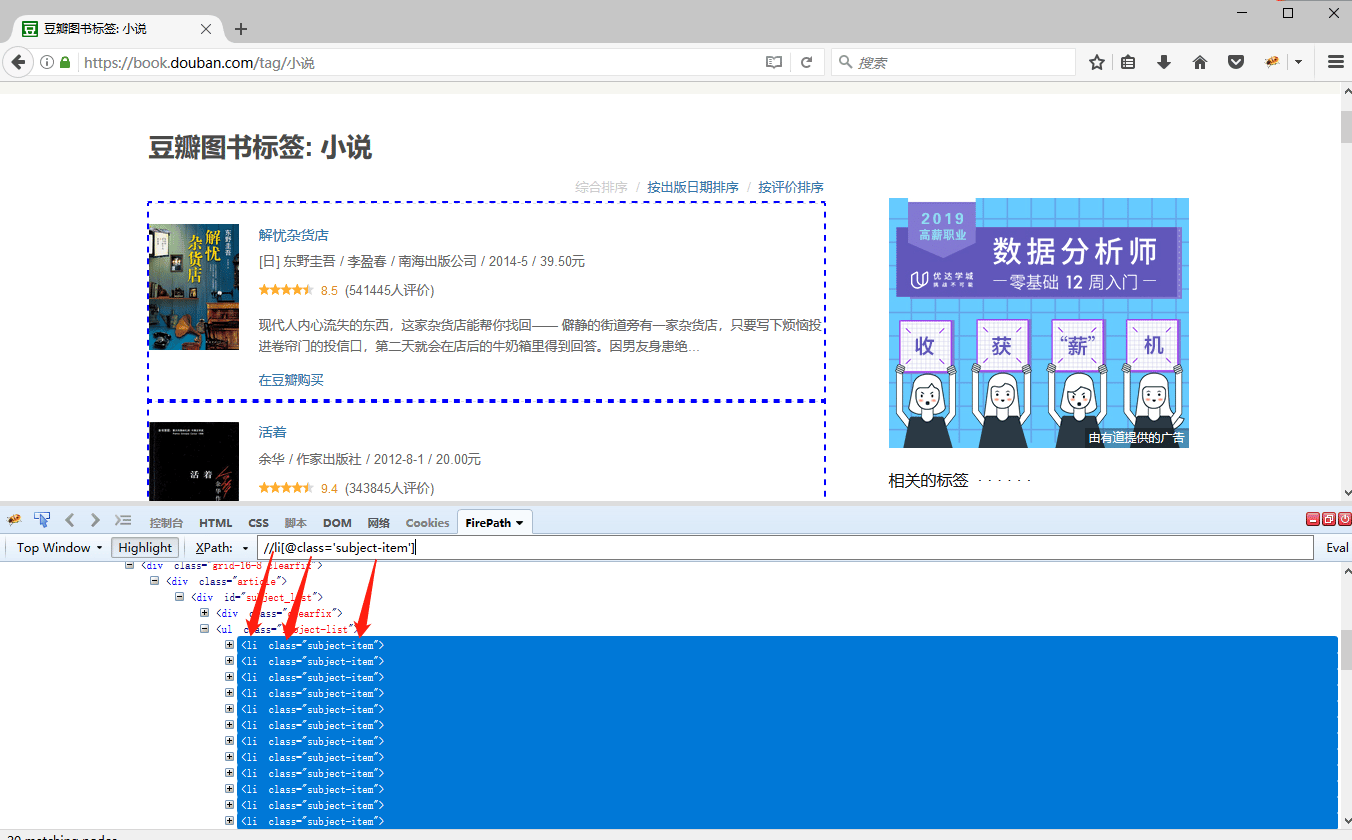
<a> </a> 定义超链接,用于从一张页面链接到另一张页面 <p> </p> 段落标记标签 <div> </div> 可定义文档中的区域或节、可以把文档分割为不同的部分,是一个块级元素 <li> </li> 创建列表内容项 <img> </img> 向网页中嵌入一幅图像,从网页中链接图像 <table> </table> 创建一个表格 <tr> </tr> 表格中的每一行 <td> </td> 表格中的标准单元格 HTML文档是树状结构,标签具有层级,标签之间具有父、子、兄弟的关系。 父(Parent):每个标签都有一个父标签。如下图,ul标签是黄框中所有li标签的父标签。 子(Children):一个标签可有零个、一个或多个子标签。如下图,li标签是ul标签的子标签。 兄弟(Sibling):同级标签,拥有相同的父标签。如下图,红框中的li标签是兄弟(同级)标签。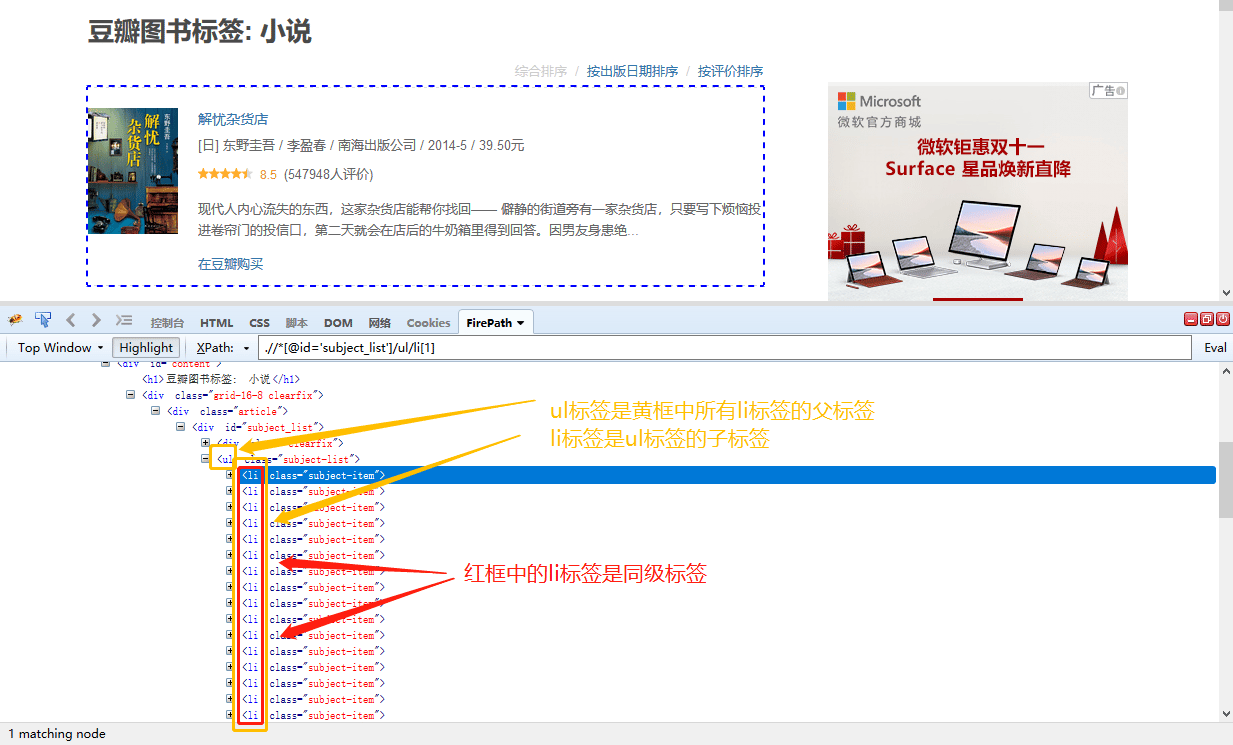
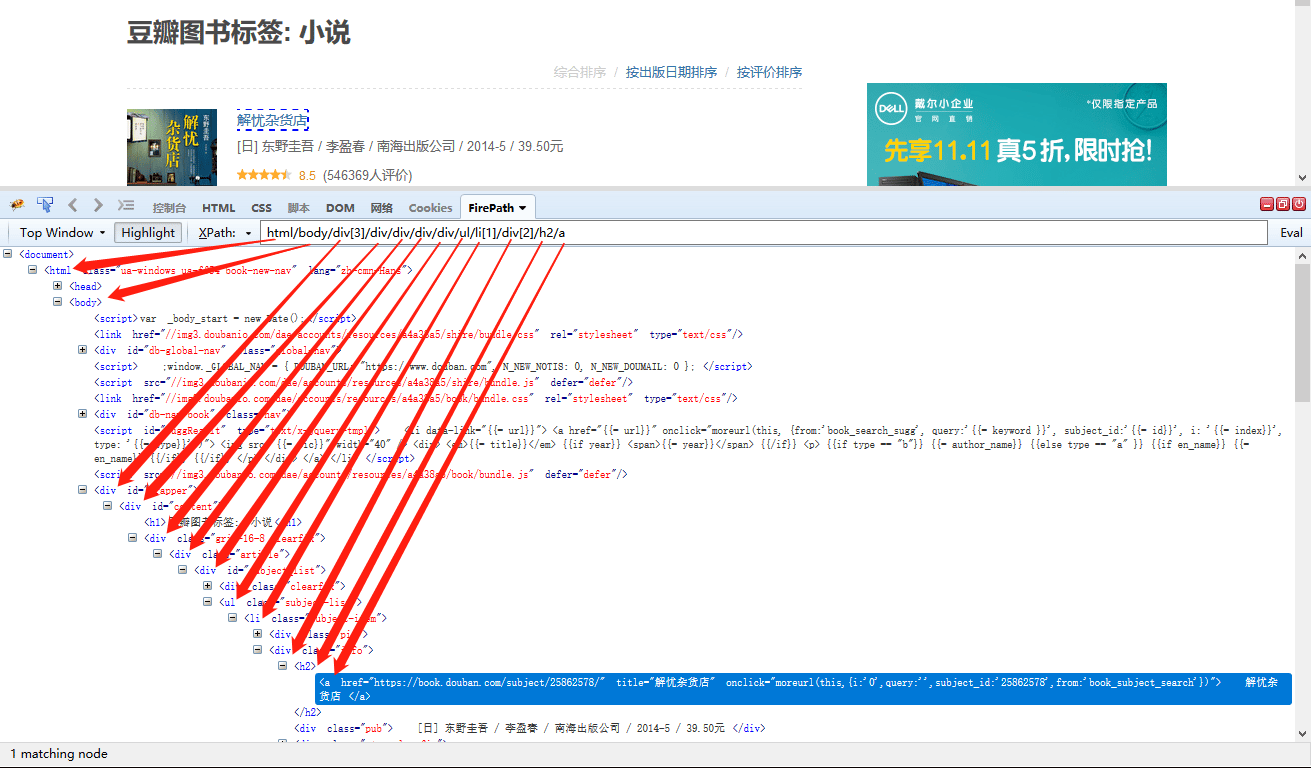
2、属性
① 常见属性 class 规定元素的类名,大多数时候用于指定样式表中的类 id 唯一标识一个元素的属性,在html里面必须是唯一的 href 指定超链接目标的url src 图像文件的url(直接复制到浏览器中,可打开图片)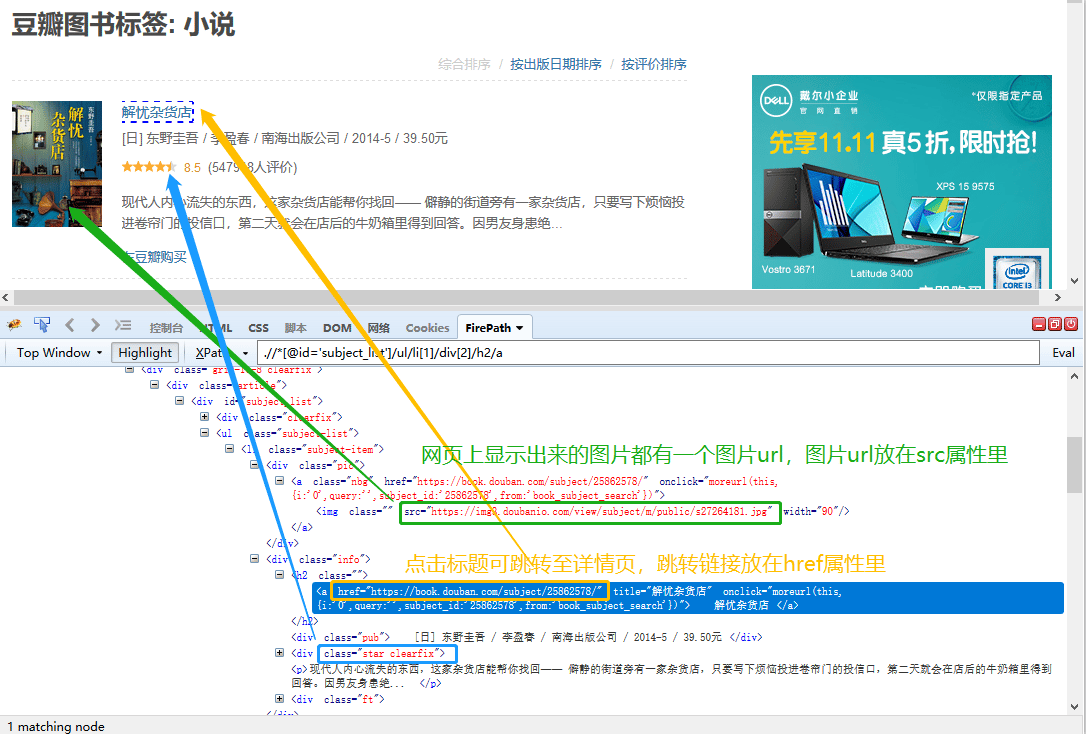
使用过程中遇到问题?前往 八爪鱼RPA 开发者社区问答板块 提问,获取官方与社区帮助。